文字渲染
MOSS Image 做中英文海报
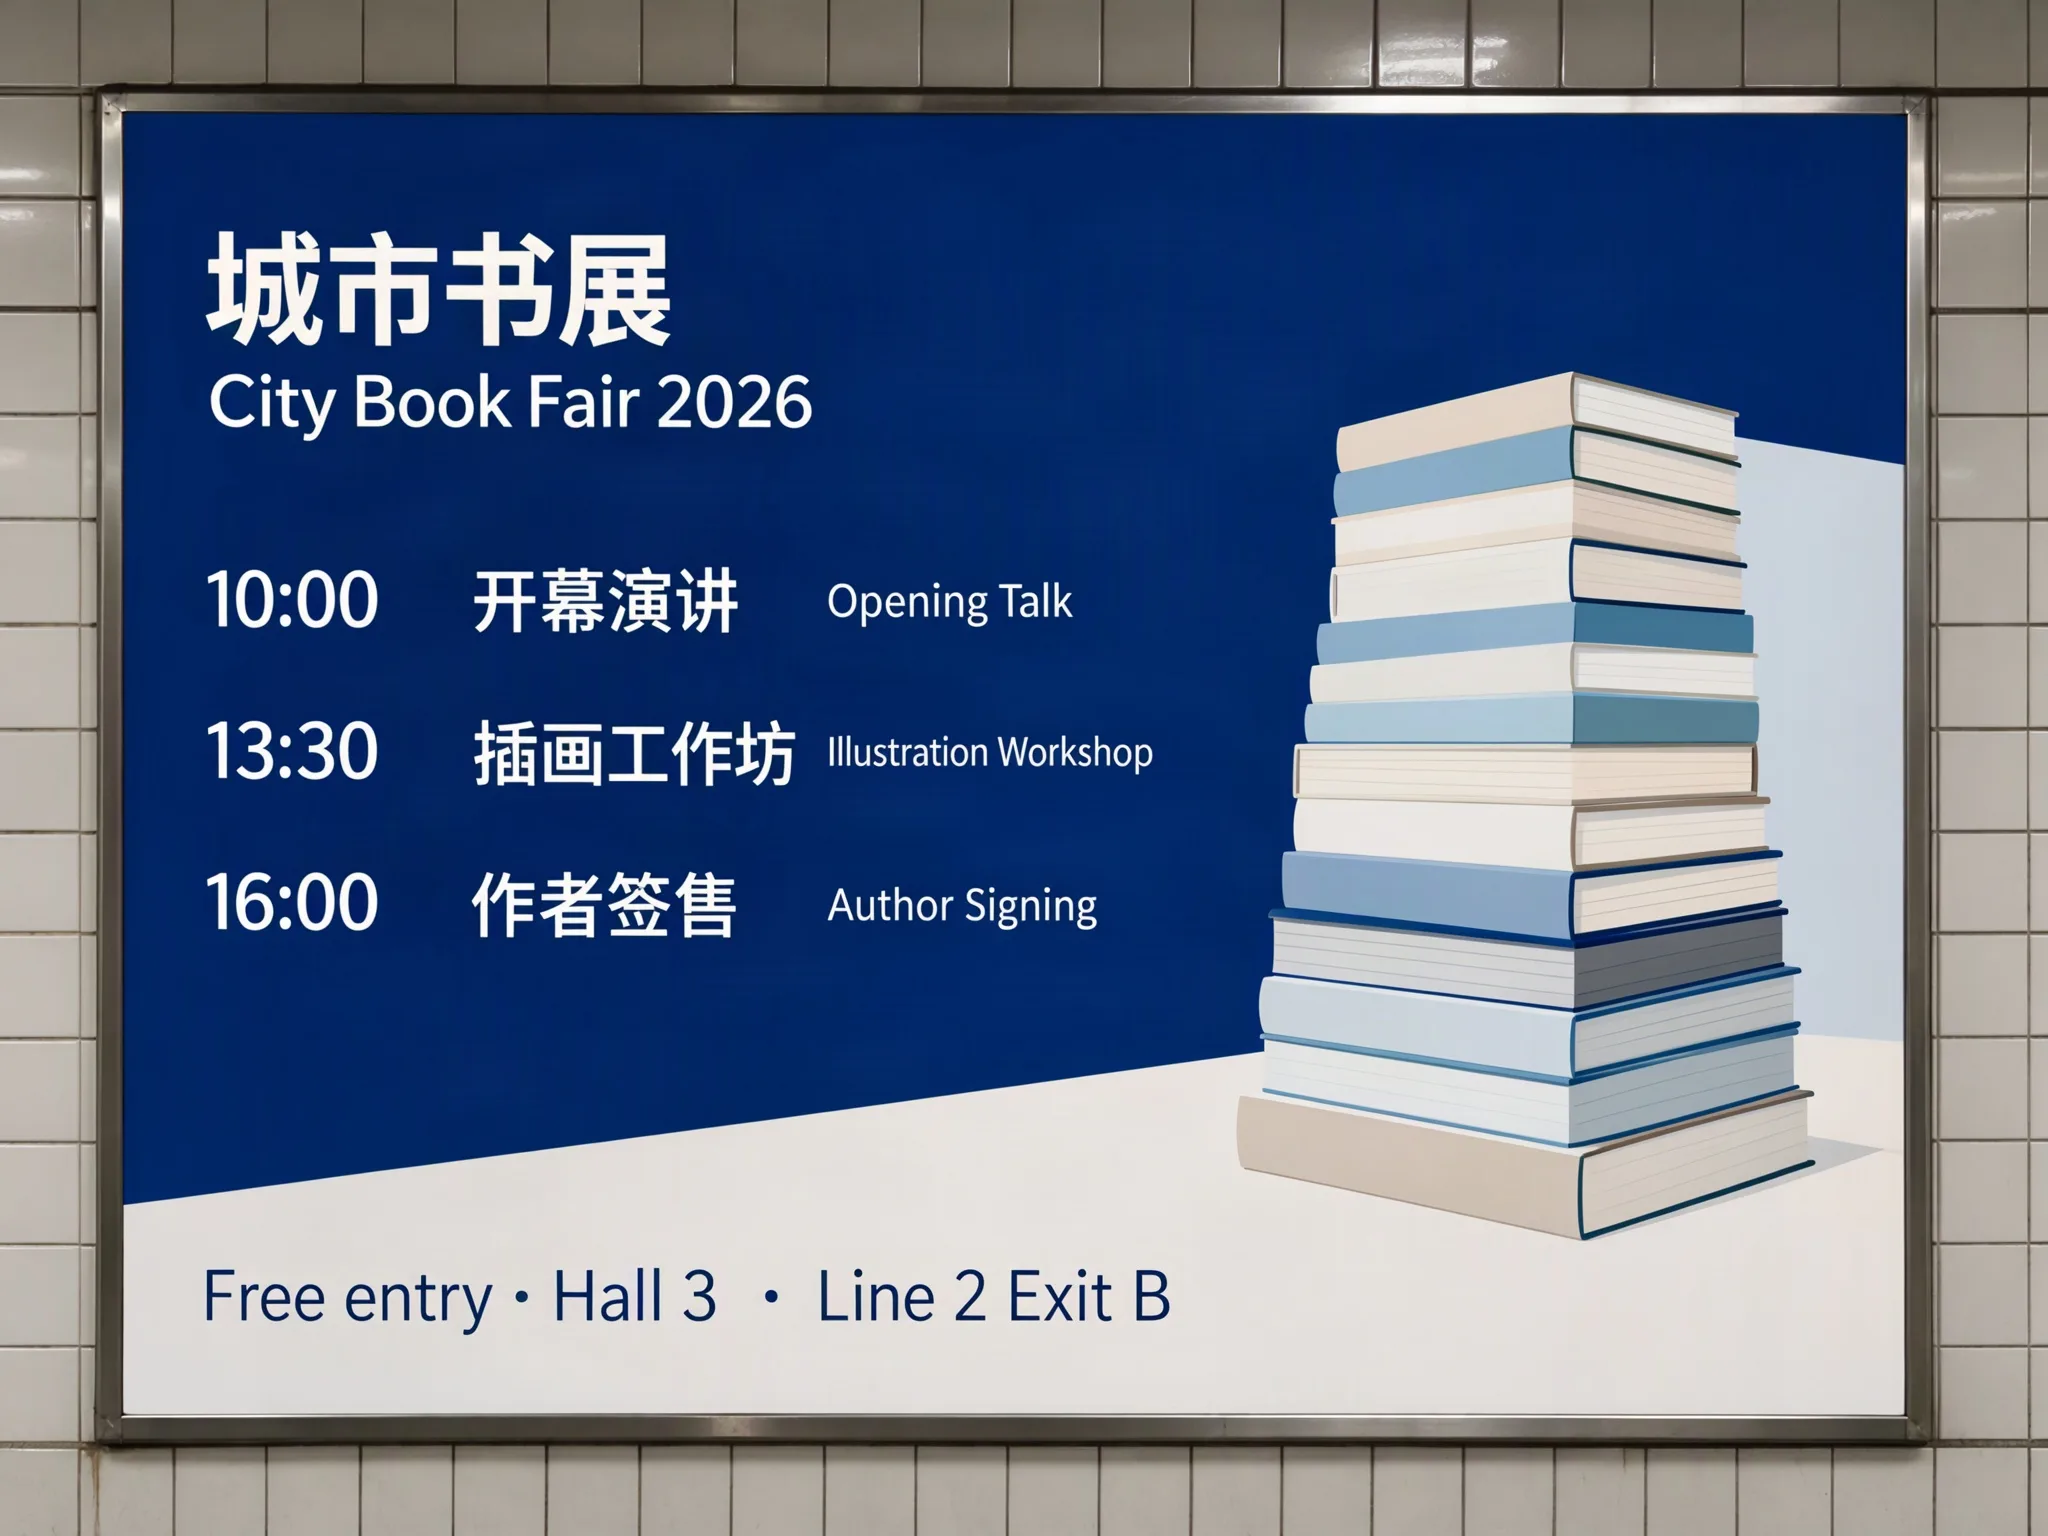
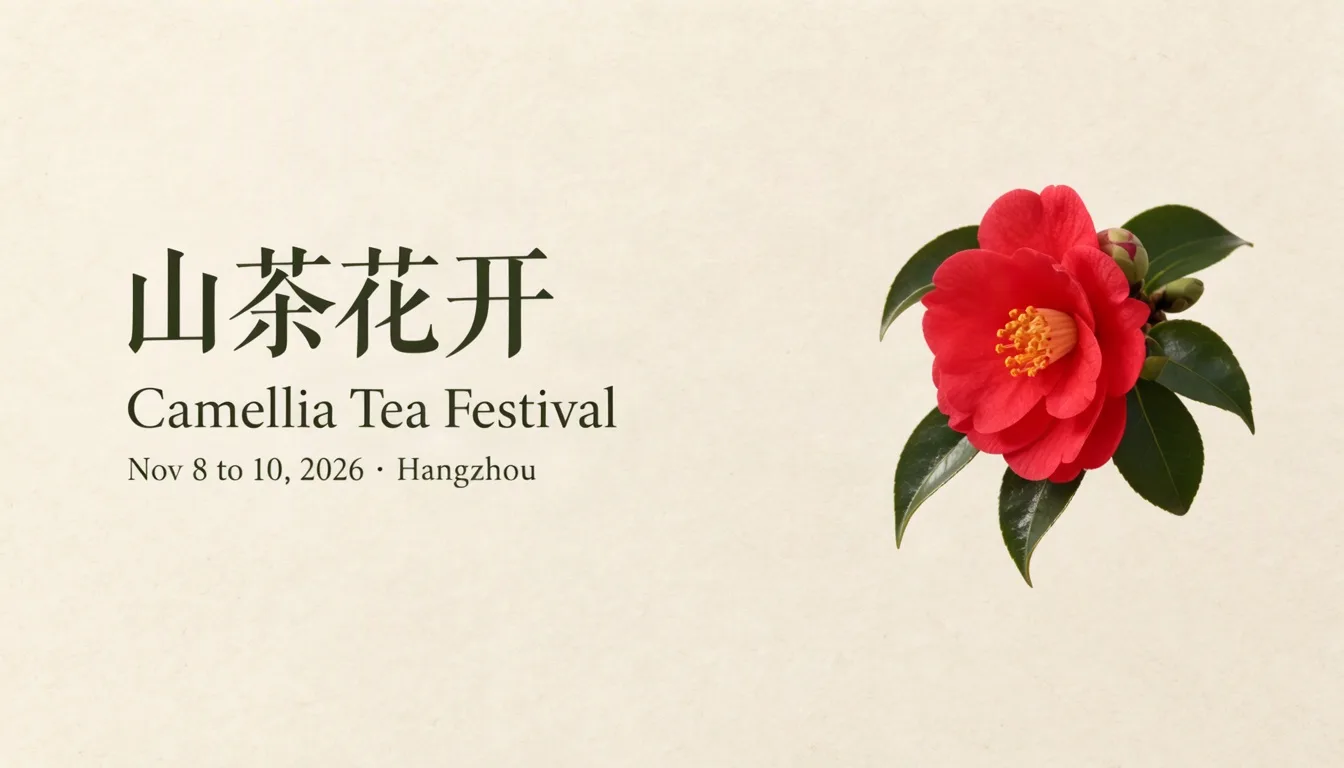
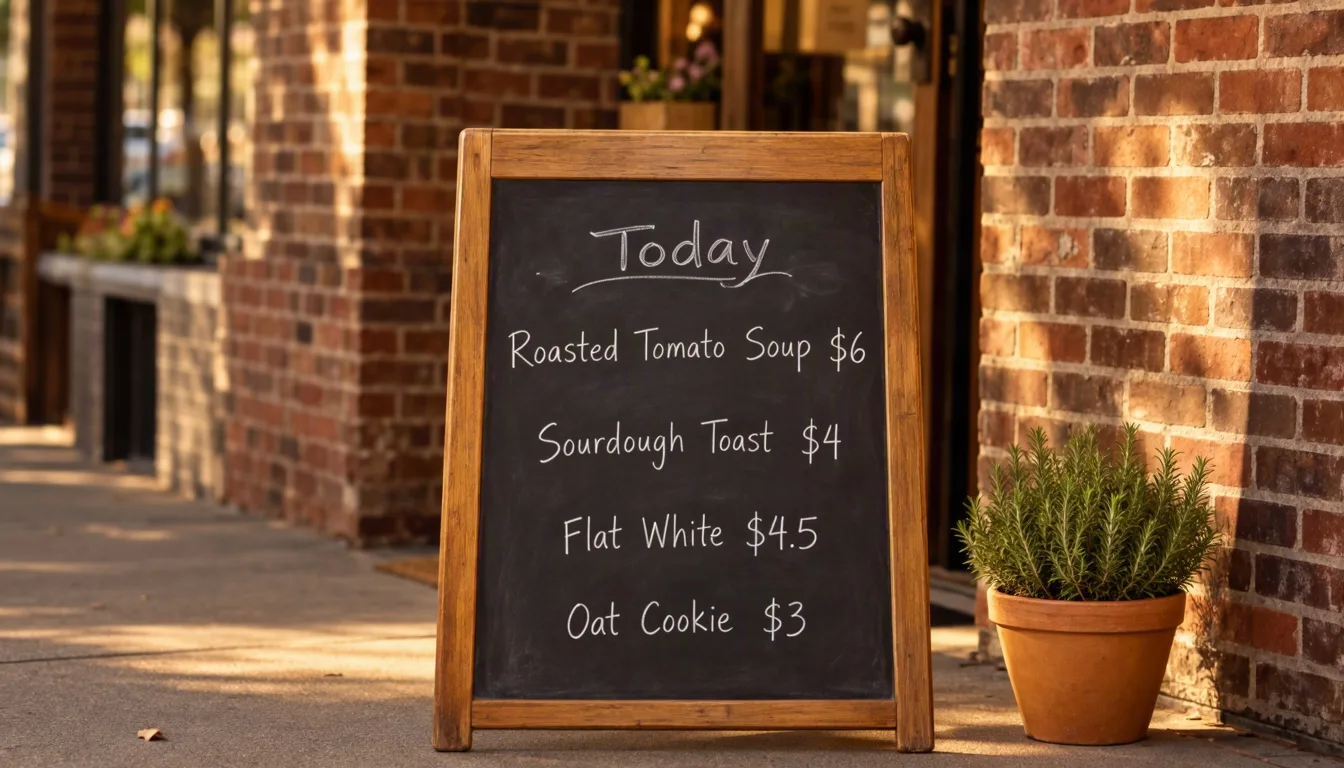
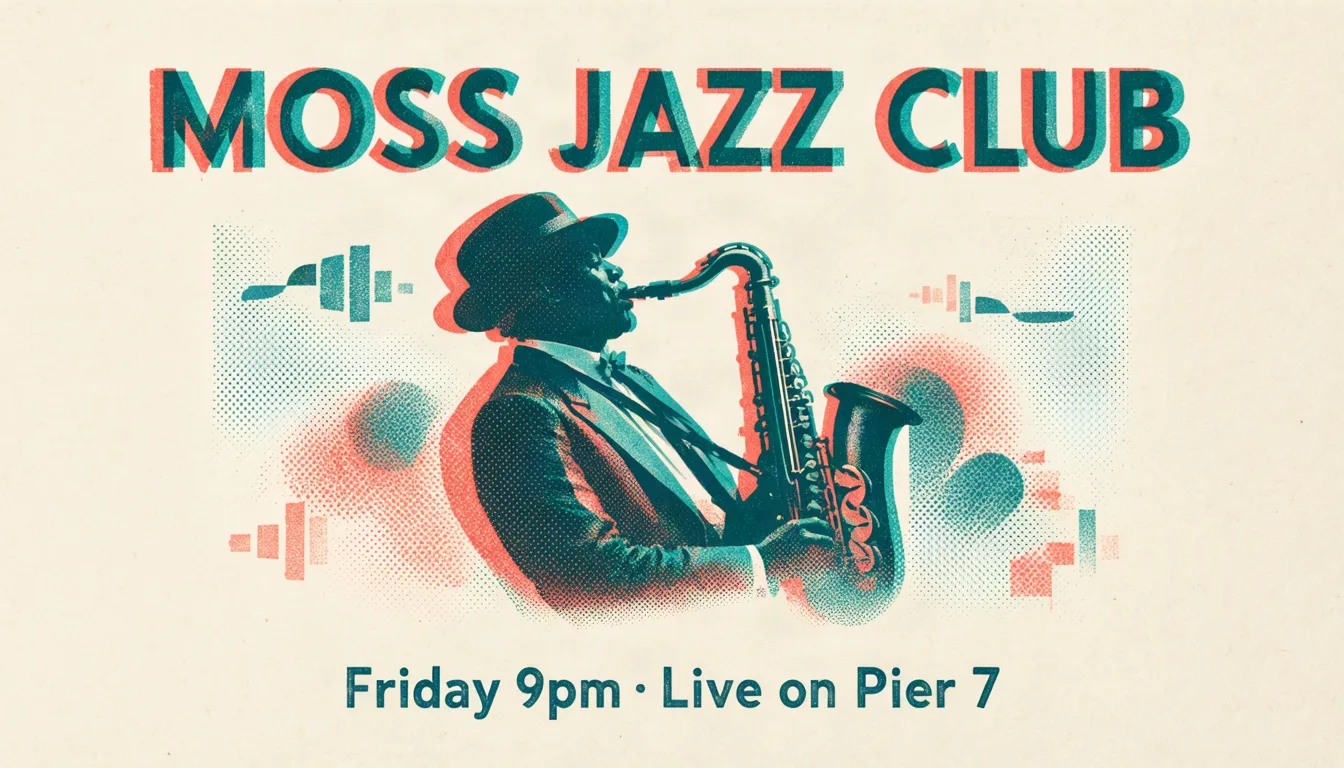
大段文字,中英都能写对。 把要出现的文字放进引号,MOSS Image 就会把它排成真正的字:标题、日程、价格、页脚小字,中文和英文可以在同一张海报上。它会自己换行,想精确控制换行时,在提示词里加换行就行。
- 中英文同图
- 小字也看得清
- 换行按提示词来
 MOSS Image
中英日程,2K
OpenMOSS 开源的 5B 生图模型,打开网页就能用。输入一句话,就能出中英文字清晰的海报、看不出 AI 味的照片和二次元插画。不用显卡,不用 ComfyUI,也不用下载 20 GB 的模型。
模型
提示词
纵横比
分辨率
Experience the power of AI image generation
MOSS Image 是 OpenMOSS 团队在 2026 年 10 月 16 日开源的文生图模型,权重采用 Apache 2.0 协议。它是一个 5B 参数的单流扩散 Transformer,提示词最长 4096 个 token,能画海报、照片、信息图和二次元插画,大段中英文字也能一个字一个字写对。
MOSS Image 的画面看起来不一样,是有原因的。团队从零训练,用了 30 亿张图片,并用自研检测器把 AI 生成的图片全部剔除。所以它出的照片有真实的光线、皮肤和生活里的杂乱,没有新模型常见的那种光滑塑料感。你还可以直接给它一段 JSON 排版,它会把每个标题、物体和标签放进你指定的框里。
 MOSS Image
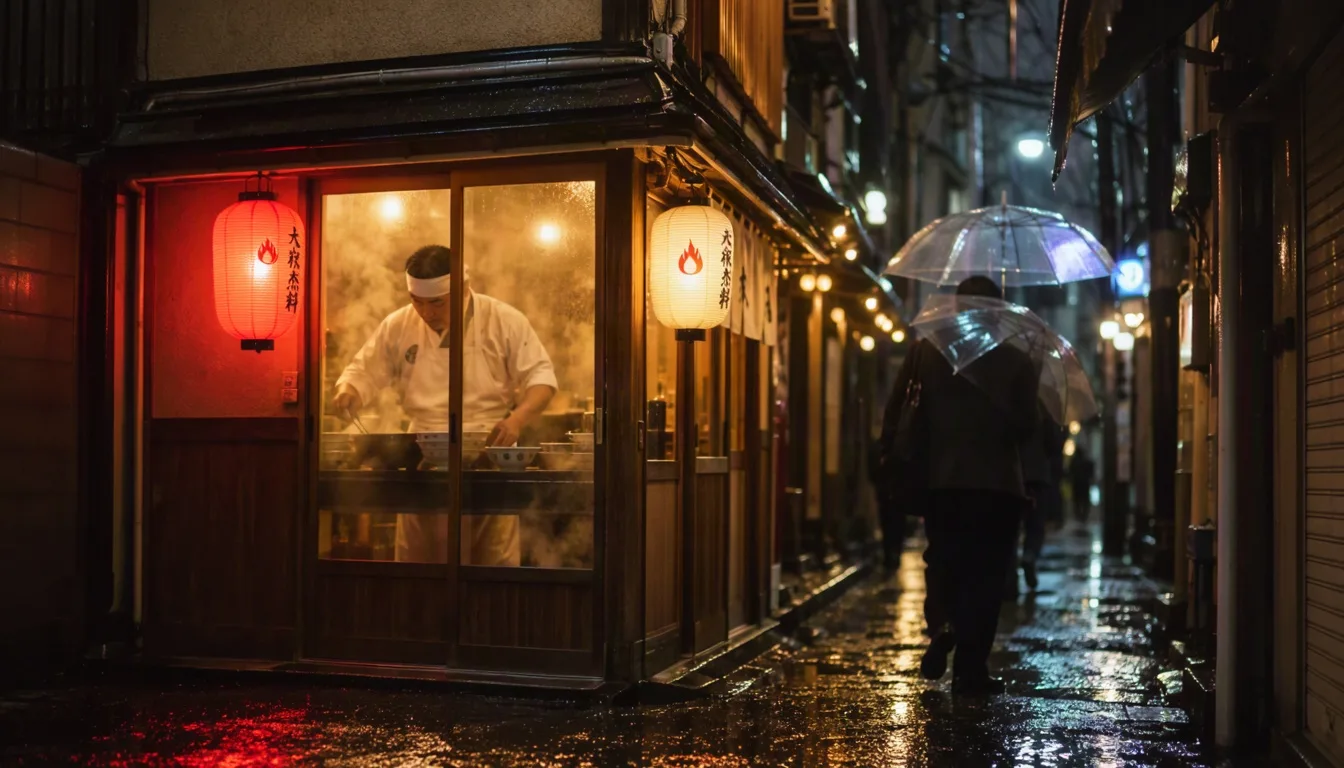
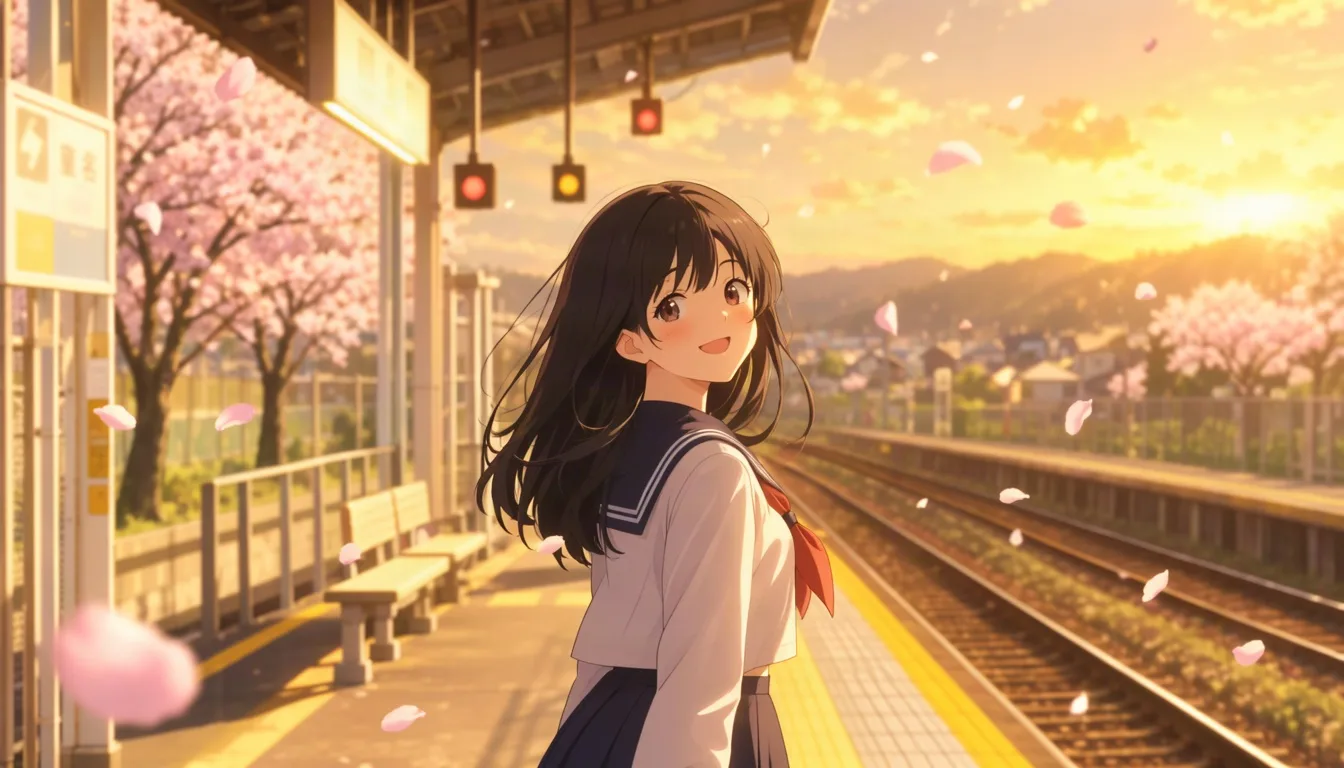
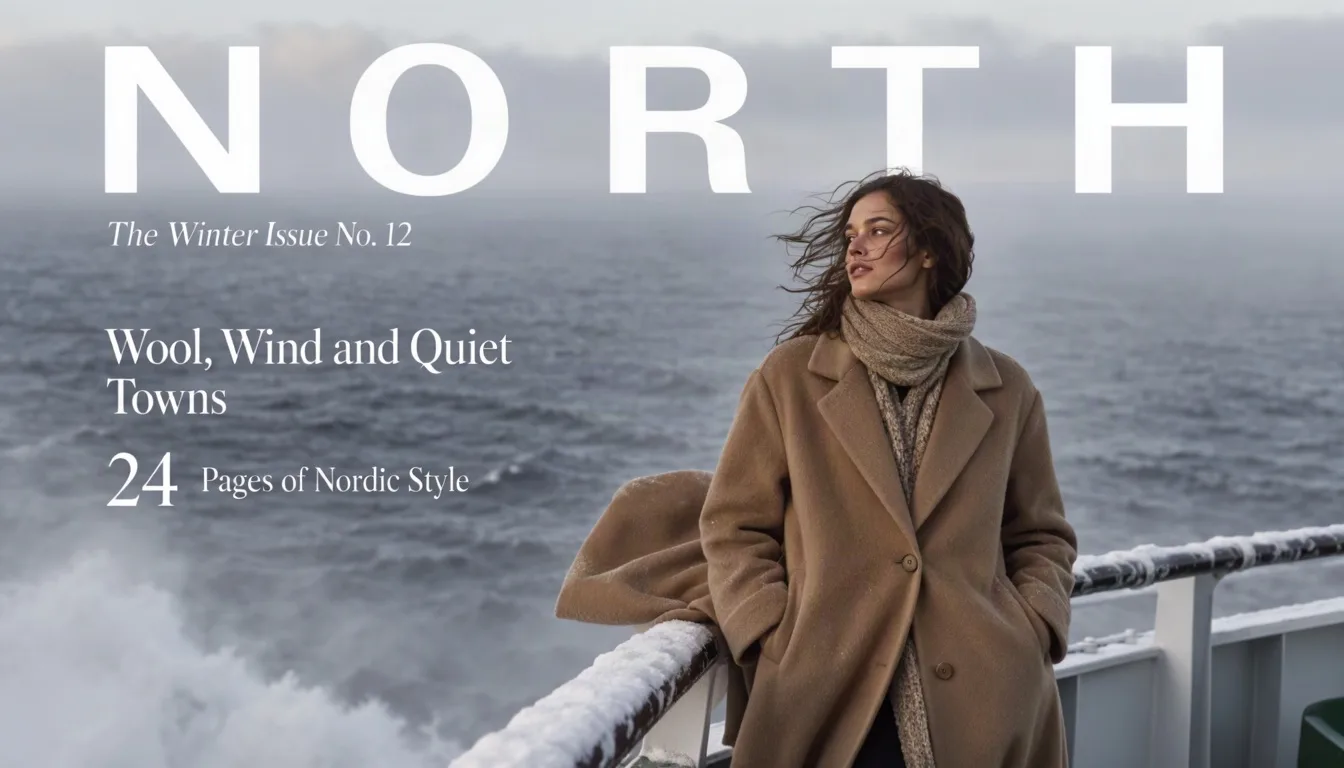
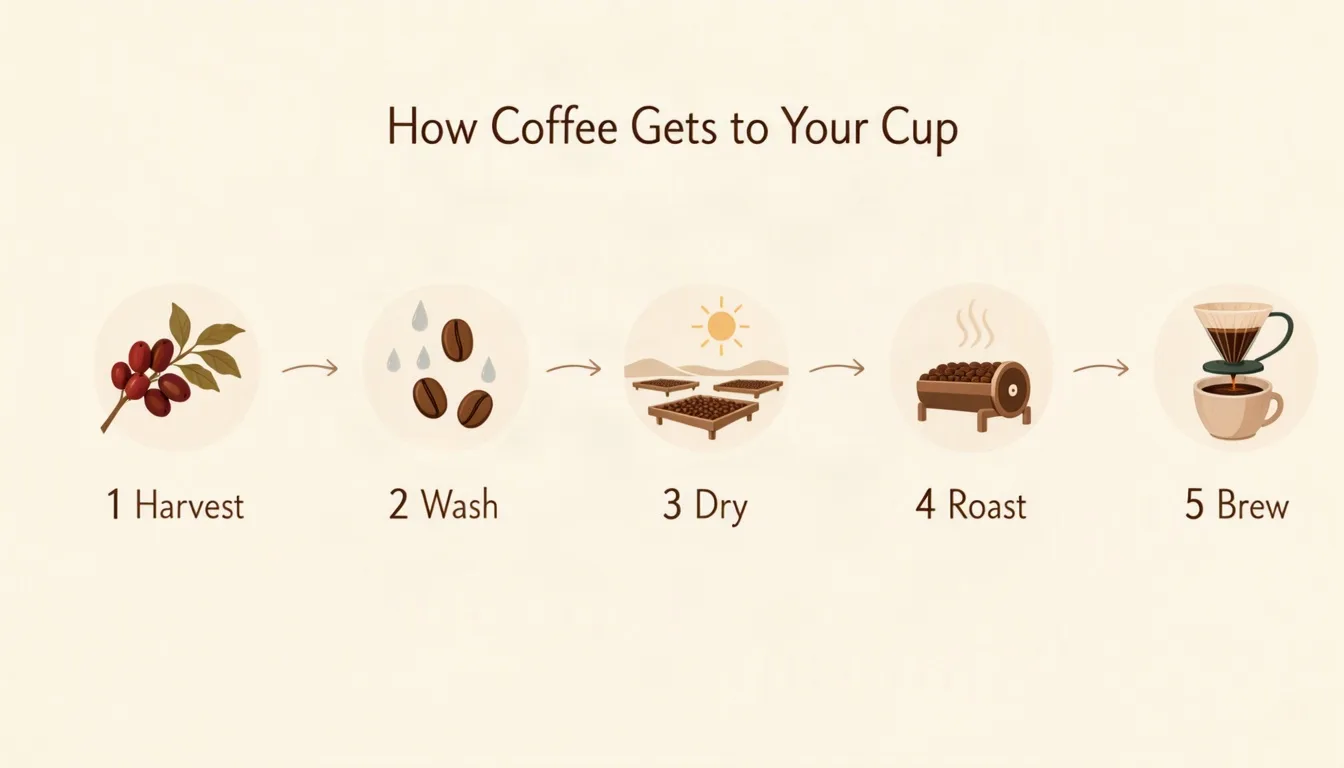
海报、街拍、二次元、杂志封面、信息图、手写便签,全部用本页的 MOSS Image 生成。把鼠标移到图片上,可以看到原始提示词。
数据来自 MOSS Image 技术报告。在设计类需求的真人盲评里,它排在 Seedream 5.0 Pro 和 Nano Banana Pro 前面;长文字和排版两项在开源模型里领先。
同一个简短需求,评审两两对比两张设计,看不到模型名。只有 GPT Image 2 得分更高。
要求写进图里的中英文内容,有多少被正确画出来。
每个物体和它的排版框重合得有多准(mIoU,越高越好)。
MOSS Image 比多数开源模型强的四个地方,每一项都配了本页真实生成的图。
大段文字,中英都能写对。 把要出现的文字放进引号,MOSS Image 就会把它排成真正的字:标题、日程、价格、页脚小字,中文和英文可以在同一张海报上。它会自己换行,想精确控制换行时,在提示词里加换行就行。
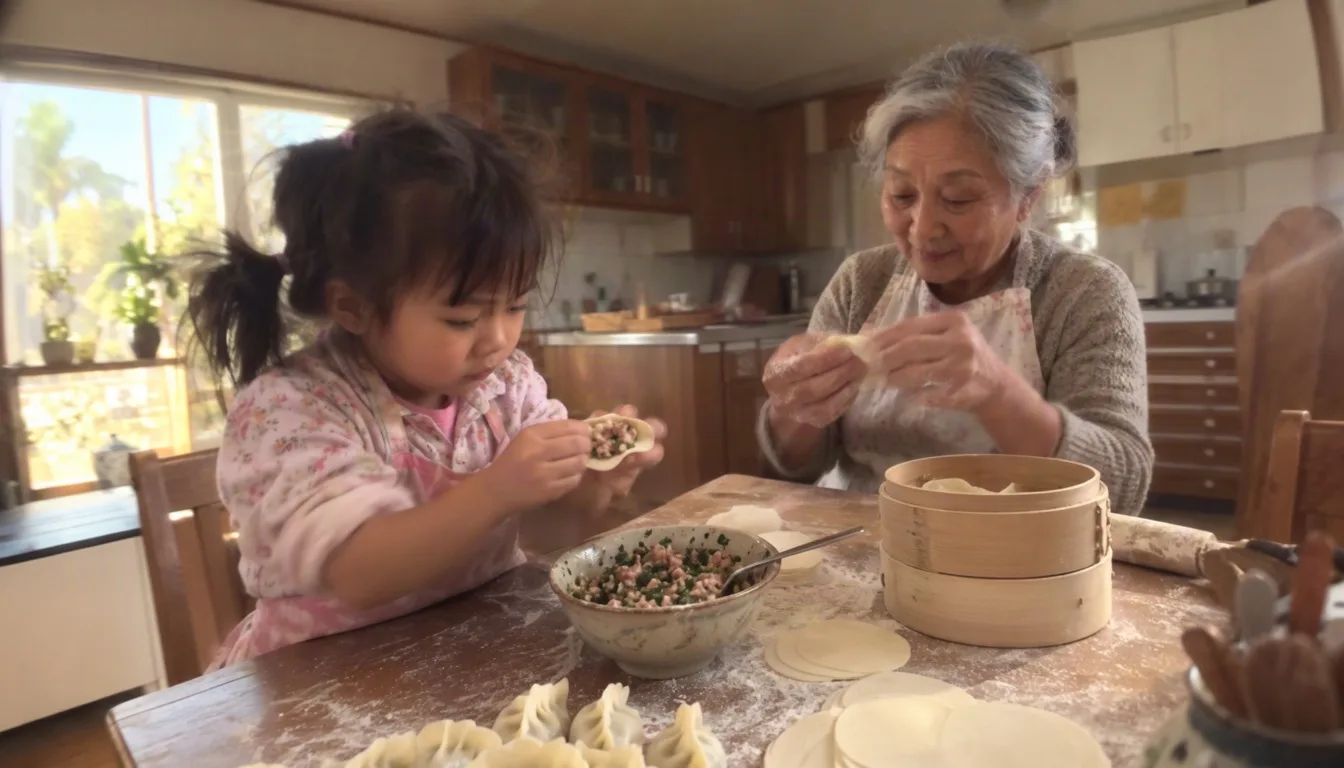
MOSS Image像拍出来的,不像生成的。 MOSS Image 的 30 亿张训练图里剔除了 AI 生成的图片,所以它没学会 AI 照片那种蜡像皮肤和磨皮光线。让它画一个日常场景,你会看到桌上的面粉、手上的动作模糊,还有家里窗户照进来的那种光。
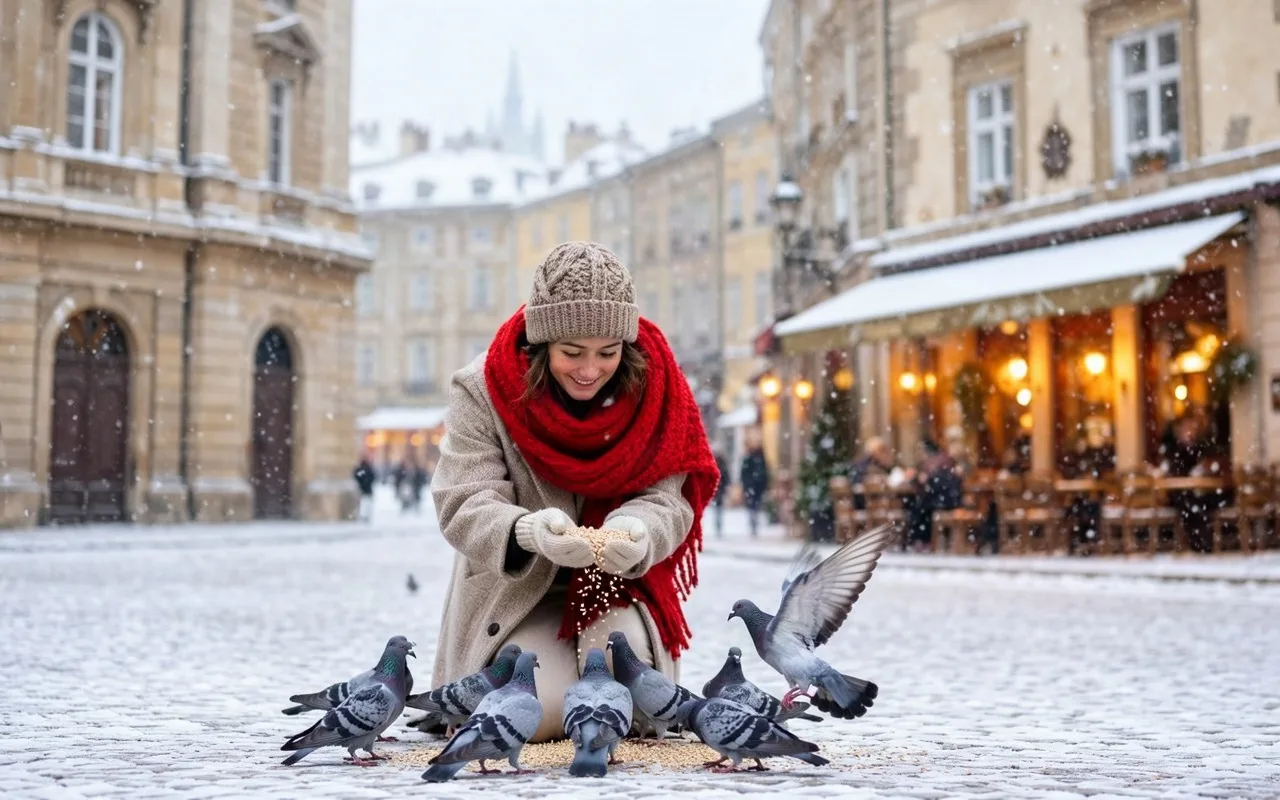
一个模型,两种画风。 写一句话就是照片,写一串标签就是二次元,MOSS Image 不用换模型就能切换画风。下面同一个场景,用一句话生成了雪天街拍,用标签生成了动画画面。
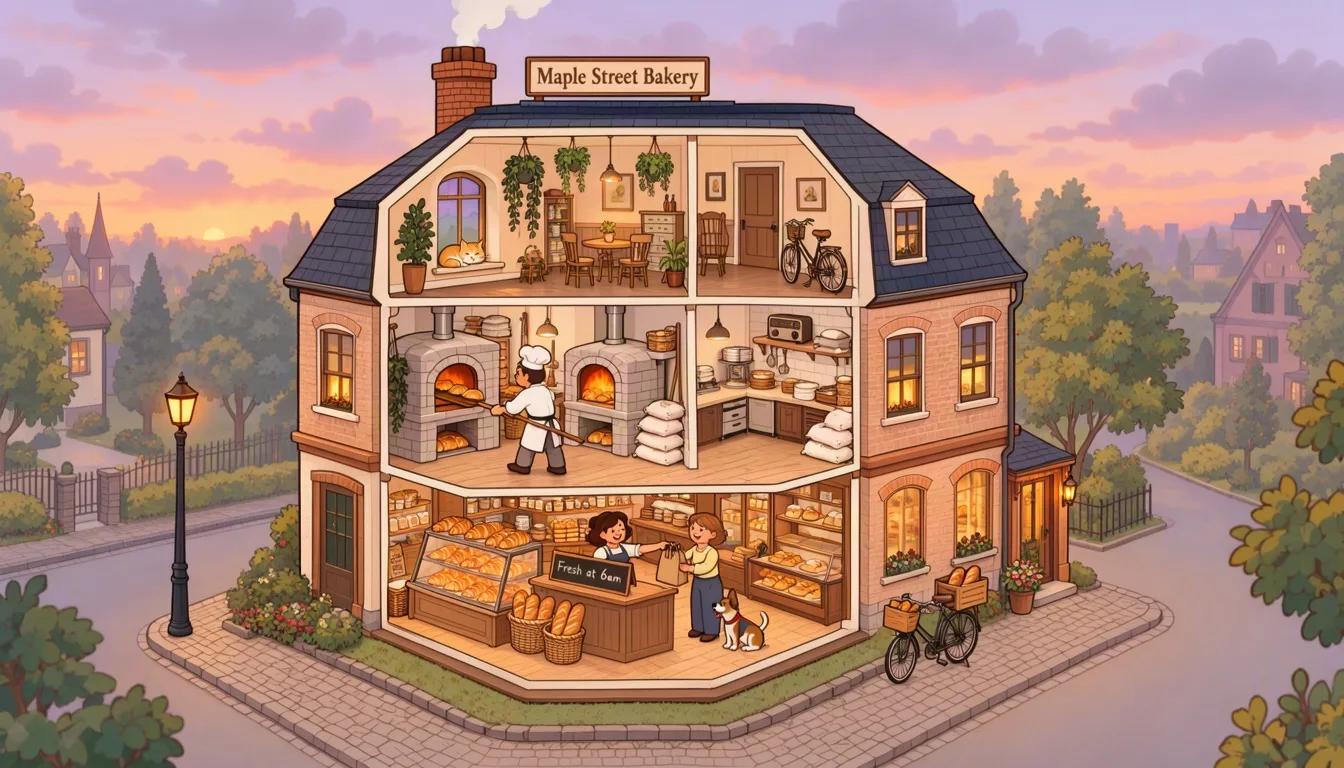
写得再细,它也跟得上。 MOSS Image 能读 4096 个 token 的提示词。你可以一层一层地描述一栋楼,它照样画出窗台上的猫、烤炉前的面包师和柜台上的小牌子。长而精确的需求不会再被截断。
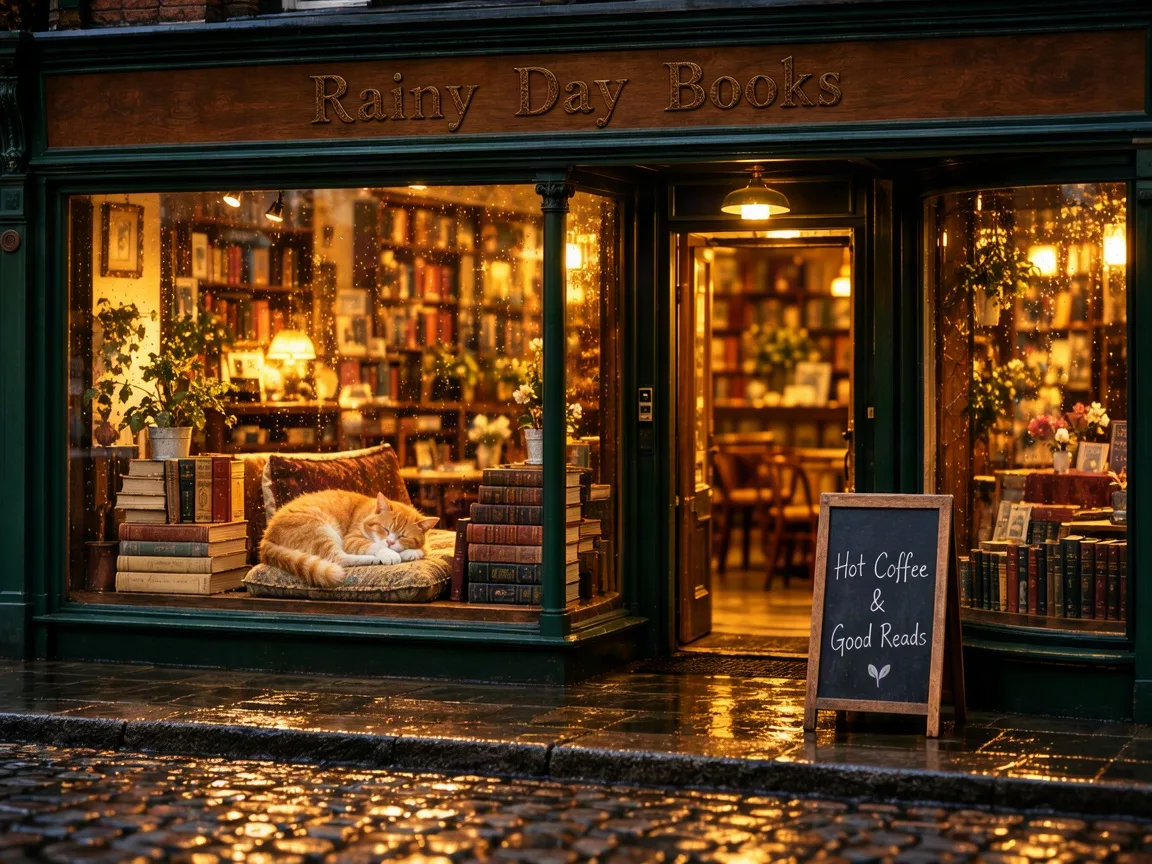
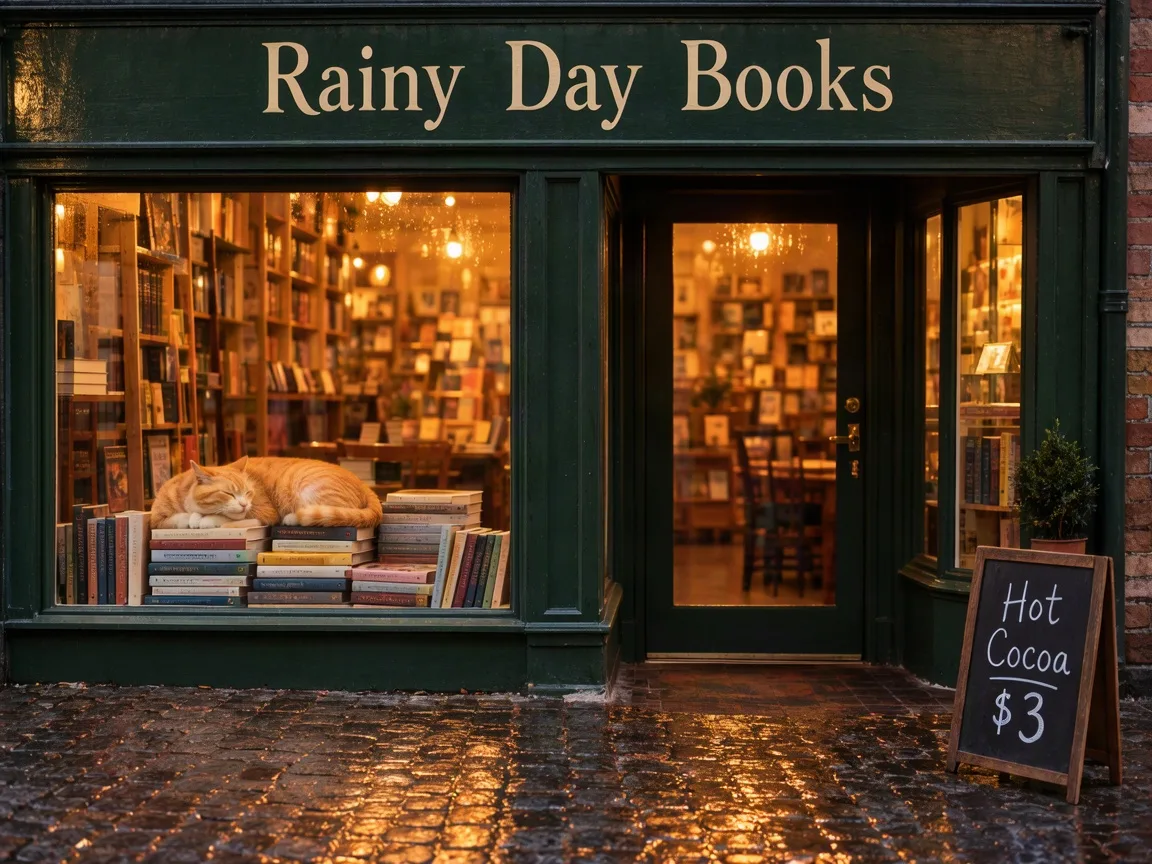
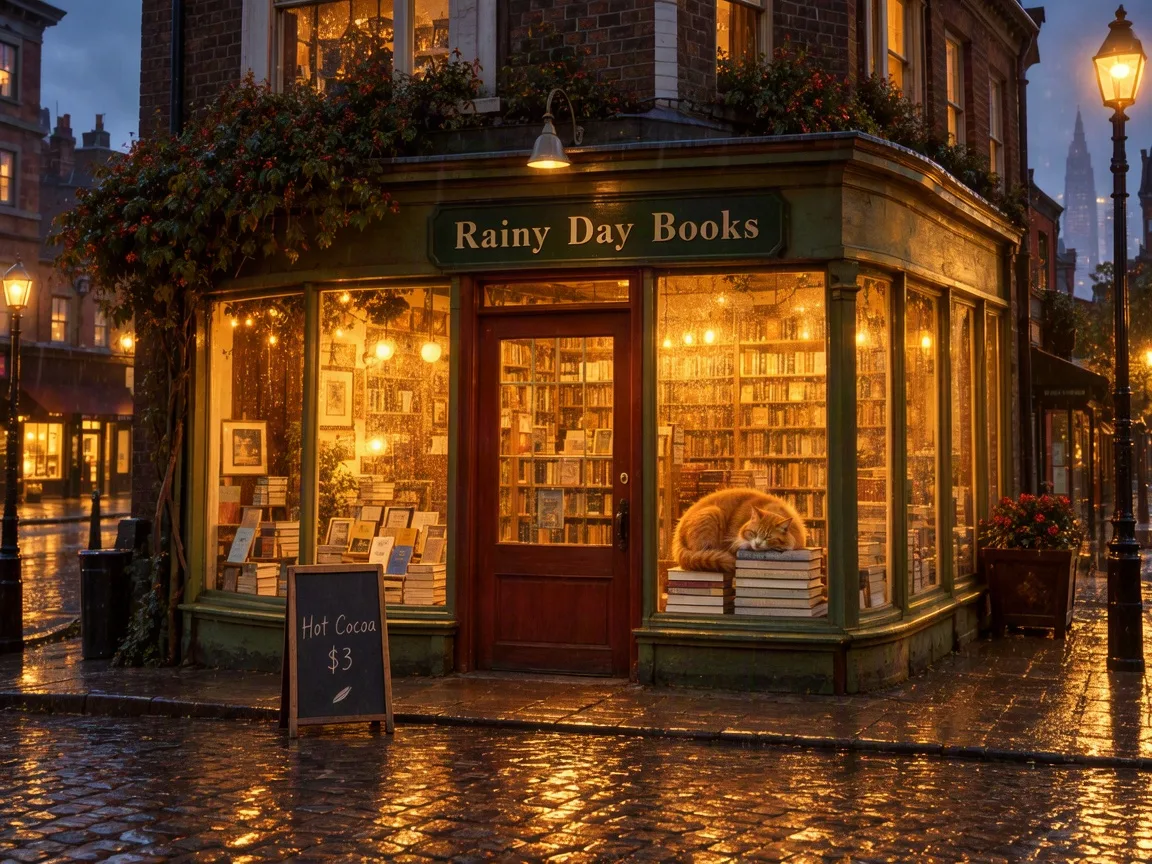
MOSS Image 能读一句话、一串标签,也能读 JSON 排版。同一家雨夜书店分别用三种写法,下面是每种写法生成的图。
用完整的句子描述画面。
提示词
A cozy corner bookstore café on a rainy evening, seen from across the wet cobblestone street. A ginger cat sleeps in the front window on a stack of books. Above the door, a dark green wooden sign reads "Rainy Day Books" in cream hand-painted letters. A small chalkboard on the sidewalk says "Hot Cocoa $3". Warm light inside, reflections on the cobblestones.
最通用的写法。要出现的文字放进引号,MOSS Image 会原样写出来。
生成结果
 MOSS Image
OpenMOSS 发布了同一个 5B 模型的两个版本:一个用来出图,一个用来训练你自己的模型。
| PixMira 在用MOSS Image SFT | MOSS Image Base | |
|---|---|---|
| 是什么 | 在精选数据上微调过的版本 | 预训练原始权重 |
| 适合做什么 | 直接出成品图 | 训练 LoRA、做微调 |
| 文字和排版 | 文字分组更整齐,版面更干净 | 同样的提示词,排版更松散 |
| 推荐参数 | 50 步,CFG 3 | 50 步以上,CFG 3 |
| 协议 | Apache 2.0 | Apache 2.0 |
左右滑动表格查看两个版本
参数来自 MOSS-Image 官方使用指南。两个版本都可以在 Hugging Face 和 ModelScope 下载。
MOSS Image 只做文生图。要改照片,或者要按参考图生成,就换成 PixMira 上的这些模型。
权重可以免费下载,但本地跑需要一张强力的 NVIDIA 显卡,还要花时间配置。两种方式的对比如下。
| 马上能用在 PixMira 在线用 | 本地 ComfyUI 部署 | |
|---|---|---|
| 硬件 | 任何能上网的手机或电脑 | 支持 CUDA 的 NVIDIA 显卡 |
| 下载 | 不用下载 | 模型 5.4 到 10.2 GB,文本编码器 7.3 到 9.8 GB,另加 FLUX.2 VAE |
| 配置 | 打开本页 | ComfyUI nightly 版或 MOSS-Image 插件,PyTorch 2.9 及以上 |
| 费用 | 1K 每张 12 积分,2K 每张 47 积分 | 免费,用自己的显卡和电费 |
| 图片保存 | 自动存进历史记录,随时下载 | 存在你自己的电脑上 |
左右滑动表格对比两种方式
文件大小来自 Comfy-Org 重新打包的 MOSS-Image(模型 int8 和 bf16,文本编码器 W4A8 和 int8)。
用本页顶部的 MOSS Image 生成器,4 步从想法到成品。
本页顶部的生成器已经帮你选好了。
画面描述用英文效果最好。要出现在图里的文字放进引号,中文英文都可以。
把一句话换成一段 JSON 排版,就能固定每个标题和物体的位置。
选好比例和 1K 或 2K,点生成,然后下载图片。
本页的真实提示词,和 MOSS Image 用它们生成的图。
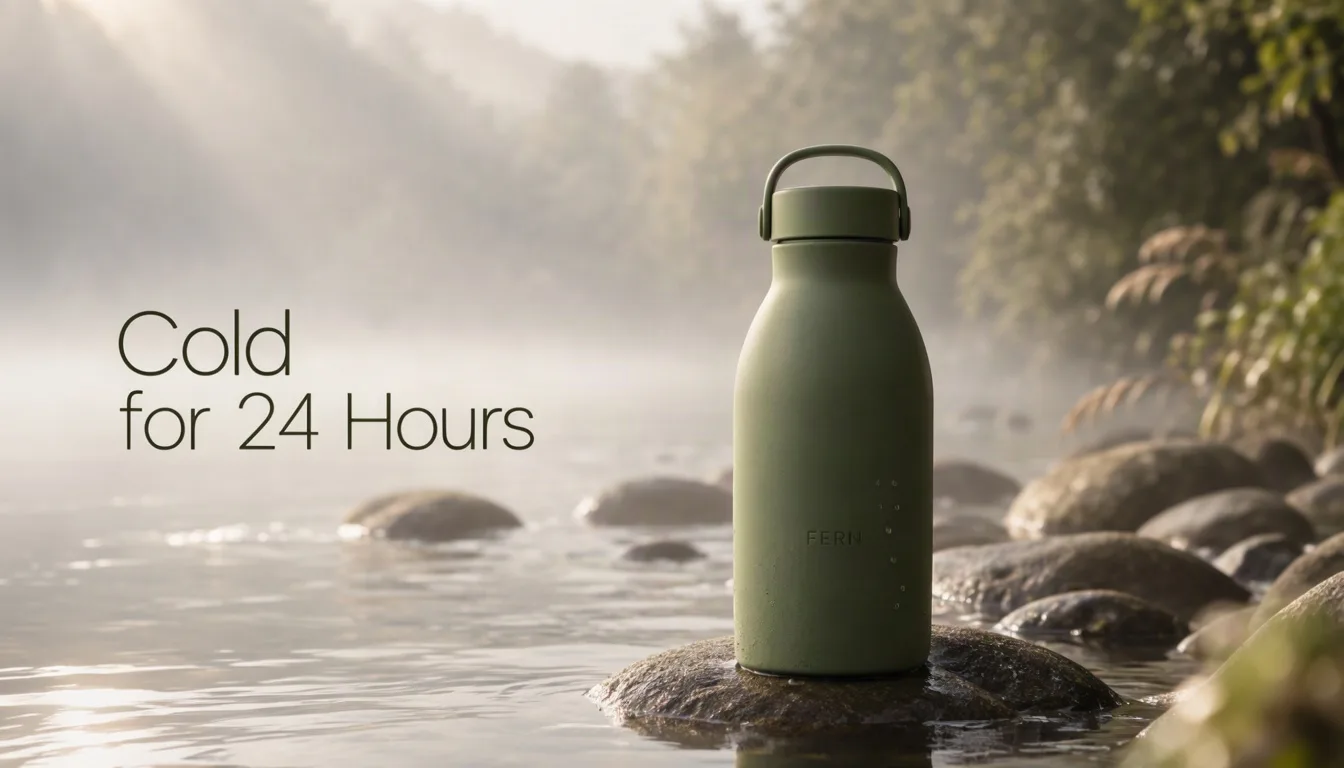
A product ad for a matte green ceramic water bottle standing on wet river stones in morning mist. Headline: "Cold for 24 Hours". Small brand word "FERN" printed on the bottle.
关于 MOSS Image 和在 PixMira 上怎么用,这里是简短回答。